
Представьте, что вы выпускаете новую моцареллу. Нужно выбрать название, объяснить цену и решить, какое обещание поставить на упаковку: про вкус, состав или быстрый ужин дома. У команды несколько вариантов, а время на выбор ограничено.
Мы каждый день обсуждаем такие задачи с нейросетями. Но прежде чем спрашивать модель, что понравится покупателям, хочется понять: насколько хорошо она вообще представляет этих людей? Поэтому мы начали с вопросов, на которые уже ответили реальные россияне.
Кого модель считает покупателем
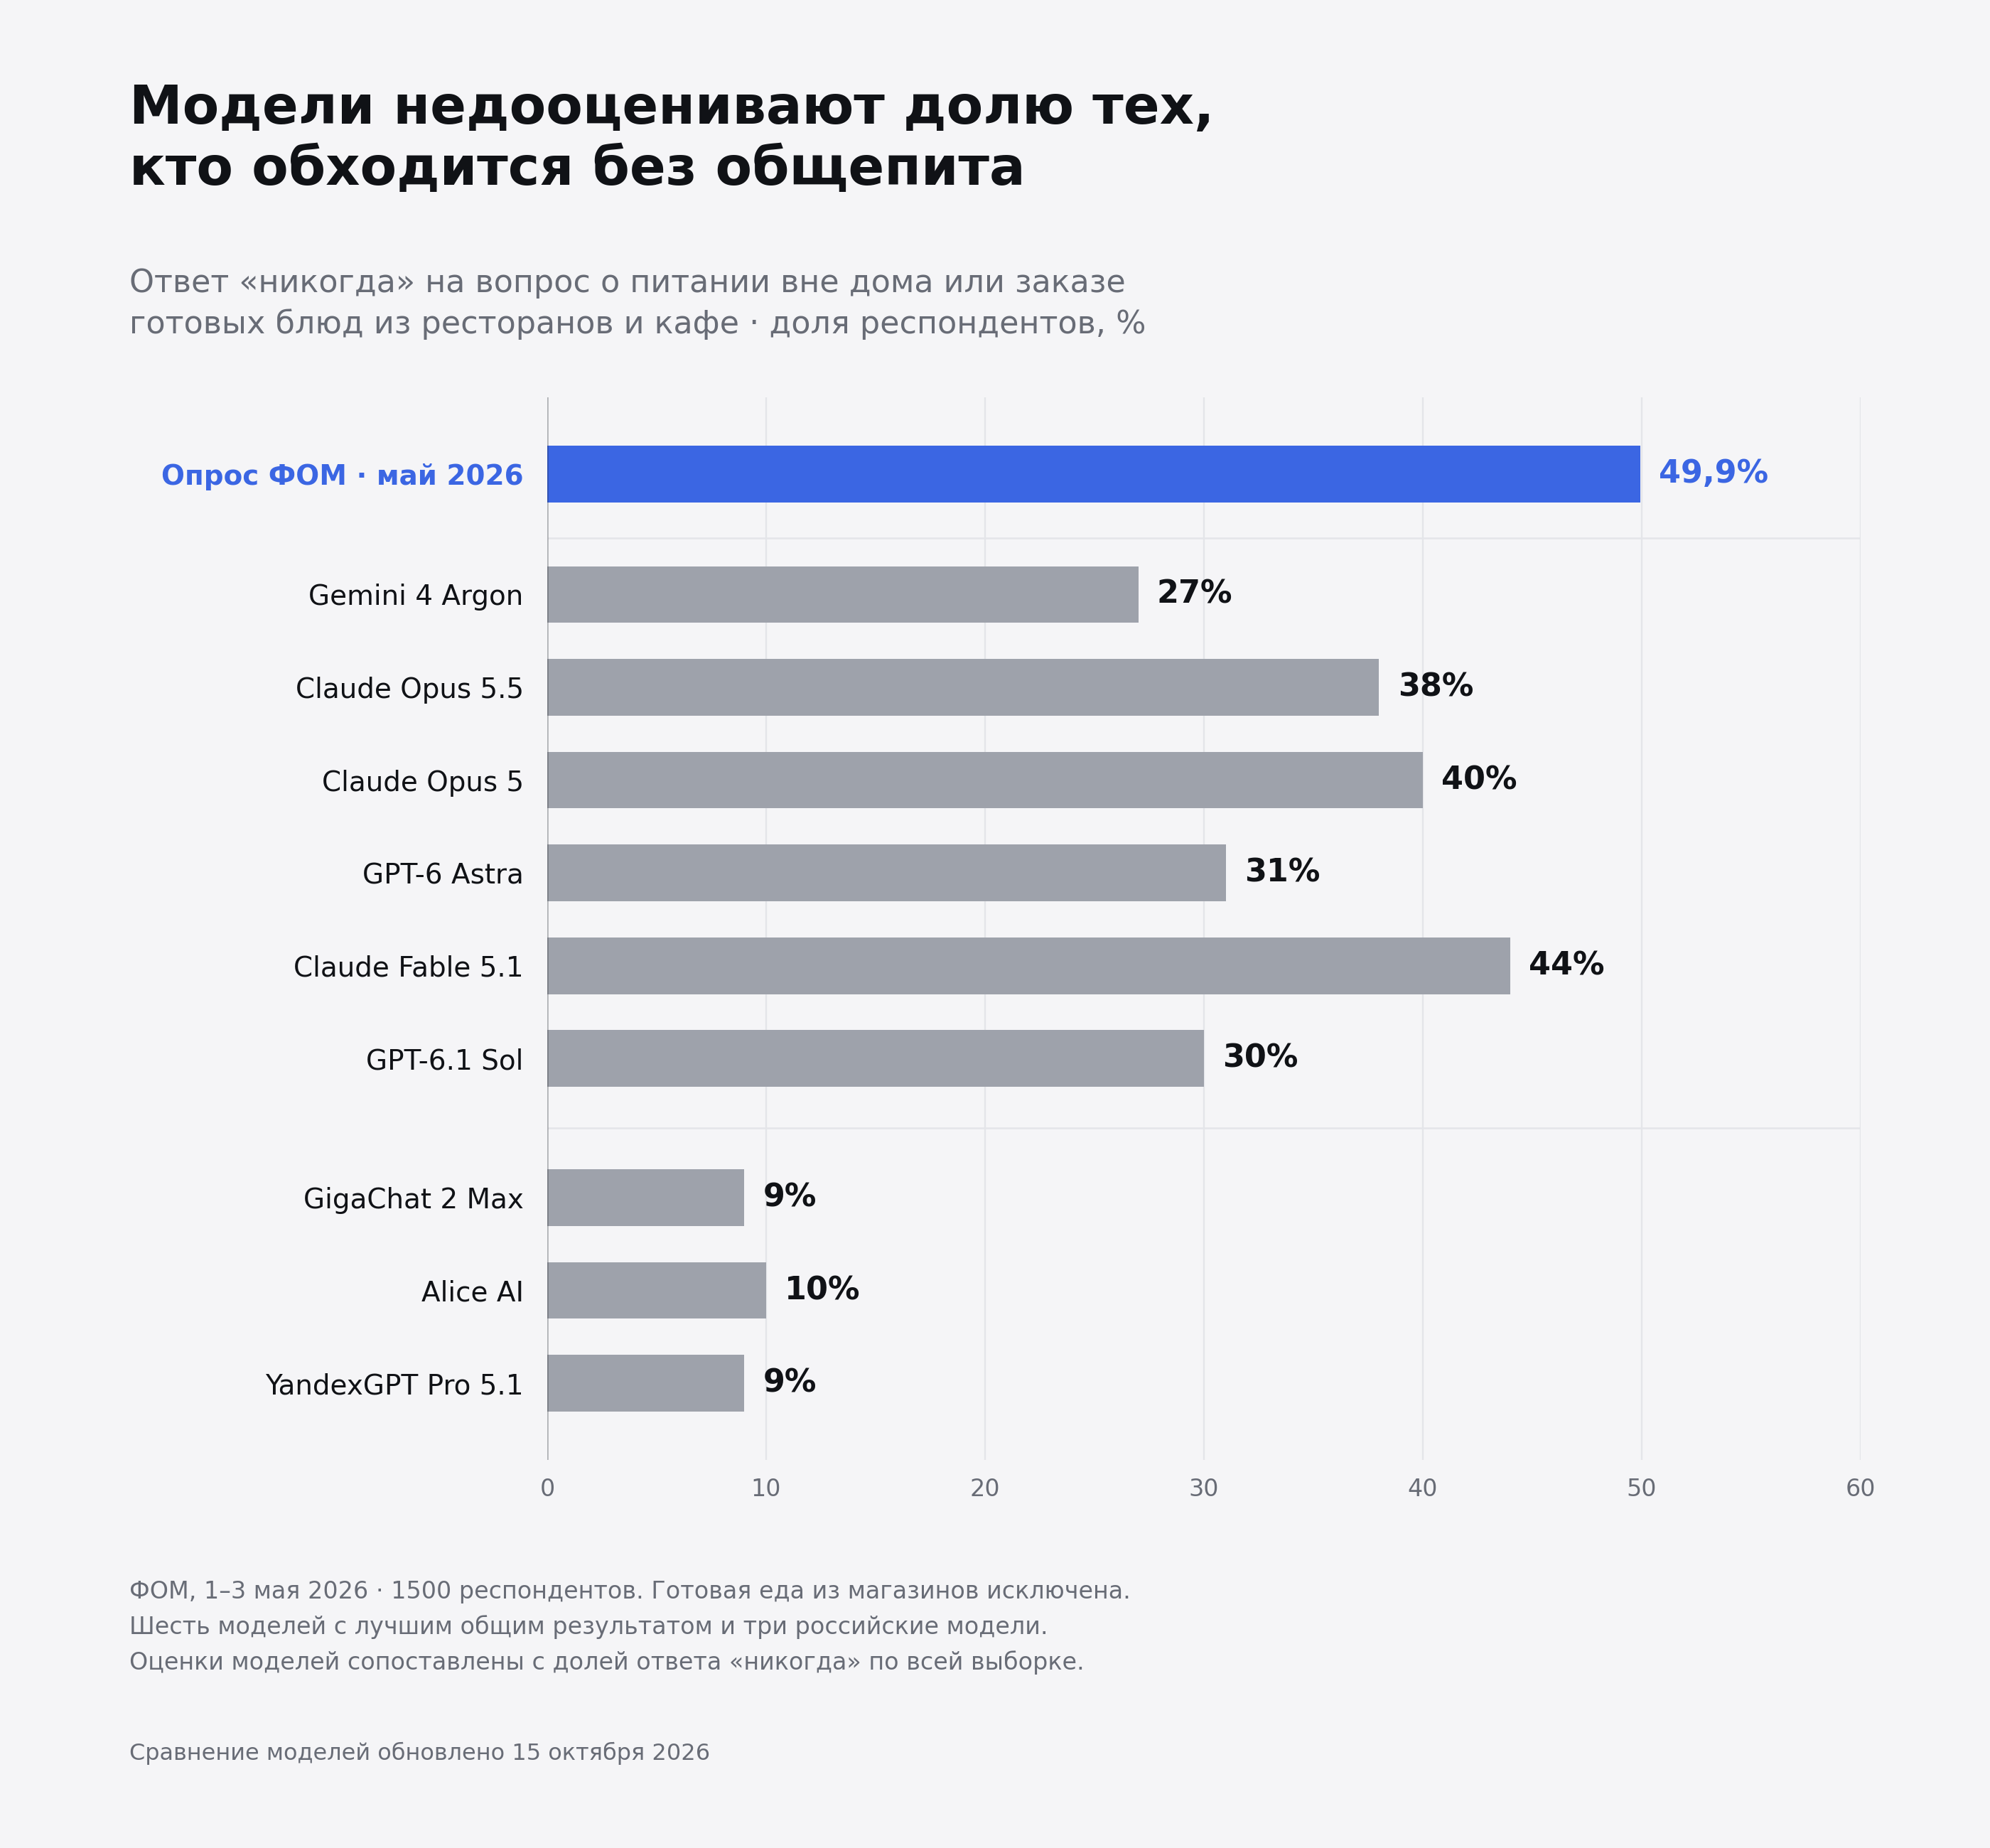
Например, сколько взрослых россиян никогда не едят вне дома и не заказывают блюда из ресторанов и кафе?
В опросе ФОМ получилось почти 50%. Gemini 4 Argon, которая показала лучший результат в нашем сравнении, предположила 27%. YandexGPT Pro 5.1 и GigaChat-2-Max дали по 9%.
Всего мы проверили 40 моделей. Долю таких людей занизила каждая. Оценки лежали от 8% до 44% — и ни одной по другую сторону от реального результата.
Проверяли мы это в «Лаборатории №40», где работаем с синтетическими исследованиями. Нам важно понимать, какие представления об аудитории модель приносит с собой ещё до того, как мы начнём расспрашивать её о конкретном продукте.
Взяли 87 вопросов из реальных российских исследований. Деньги, покупки, жильё, здоровье, повседневные привычки — всего девять тем. Показывали модели вопрос, варианты ответа и период опроса, просили оценить доли ответов. Потом сравнивали с тем, что сказали люди. Результаты заранее не подсказывали, поиск в интернете не включали.
87 × 40 = 3 480 заданий для моделей. В итоговое сравнение вошли 3 470 ответов; десять не удалось получить в пригодном для сравнения виде. Да, мы занимаемся всем этим занудством, чтобы вам не пришлось.
Источниками были опросы ФОМ и ВЦИОМ, данные обследования потребительских финансов Банка России. Вместе они охватывают 2024–2026 годы. Таблицу моделей последний раз обновили 15 октября 2026-го.
Теперь вернёмся к этим 50% и 9%.
Если смотреть на оценку YandexGPT или GigaChat, может показаться, что почти все уже знакомы с едой из заведений, а людей, которые обходятся без неё, осталось немного. В реальном опросе их около половины.
Для бренда на магазинной полке здесь важен сам вопрос: кого модель уже записала в покупатели категории? В нашем примере с моцареллой стоит отдельно разобраться с теми, кто регулярно покупает свежие сыры, берёт их изредка или вообще выбирает другие продукты. Если заранее считать всех покупателями, обсуждение быстро сведётся к тому, какое название им больше понравится. А причину попробовать продукт мы так и не выясним.
Ресторанный опрос, конечно, ничего не измеряет о покупателях сыра. Он показывает, почему стоит проверить представление модели об аудитории ещё до того, как обсуждать с ней новинку.
 Открыть график в полном размере
А российские модели? Им ведь должно быть понятнее, как мы живём.
По крайней мере, такое ожидание легко понять. Поэтому среди участников были Alice AI LLM и YandexGPT Pro 5.1 от Яндекса, GigaChat-2-Max от Сбера.
Вот их места по близости оценок к реальным опросам:
| Модель | Место из 40 |
|---|---|
| GigaChat-2-Max | 36 |
| Alice AI LLM | 37 |
| YandexGPT Pro 5.1 | 39 |
Все три в последней пятёрке. Преимущества на вопросах о российских потребителях не получилось.
Есть и пример ближе к покупкам в магазине. В опросе ВЦИОМ об импульсивных покупках, проведённом в ноябре 2025 года, 63% участников сообщили, что им случалось покупать что-то спонтанно. YandexGPT Pro 5.1 предположила 85%, Alice AI LLM и GigaChat-2-Max — по 75%. А GPT-6.1 Sol дала ровно 63%.
Здесь спрашивали об опыте незапланированной покупки вообще. Это не доля импульсивных товаров в корзине и не вероятность купить конкретную шоколадку. Одни модели завысили долю людей с таким опытом, а GPT-6.1 Sol на этом вопросе совпала с опубликованной долей.
Это не оценка того, насколько хорошо Яндекс или GigaChat пишут по-русски и помогают в делах. Мы проверяли конкретные версии на конкретном умении: оценить, сколько людей выбрали бы тот или иной ответ. И между тремя российскими моделями разница пока недостаточно убедительна, чтобы объявлять одну победителем.
Есть и более удачные темы. YandexGPT Pro 5.1 занял 13-е место по вопросам о ценностях, GigaChat-2-Max — 15-е по вопросам о материальном положении. Но выбирать модель только потому, что она российская и поэтому наверняка лучше знает россиян, я бы после такого сравнения не стал.
У людей ещё бывает ответ «не знаю».
В том же исследовании ФОМ был вопрос о приемлемом счёте за праздничный ужин на одного человека. Примерно треть опрошенных — 33% — затруднились назвать сумму.
Ни одна из 40 моделей не предположила столько затруднившихся. У Alice AI LLM получилось 3%, у YandexGPT Pro 5.1 — 2%, у GigaChat-2-Max — 5%. Даже самая высокая оценка среди всех моделей — 21%.
В модельных оценках больше людей могут назвать конкретную сумму. Её можно записать в таблицу и обсуждать. В настоящем опросе треть людей эту сумму не назвала.
Для маркетолога это довольно удобный воображаемый покупатель: пользуется категорией, может назвать приемлемую цену, готов ответить на вопрос. С настоящим бывает сложнее. Он может ничего такого не покупать, не интересоваться предложением или просто не знать, сколько нормально потратить на ресторан.
И это тоже часть аудитории. Она легко теряется, когда мы начинаем сразу с вопроса «какую цену вы готовы заплатить?».
Хорошо, а если перепроверить ответ другой нейросетью?
Такой выход напрашивается сам собой. Если несколько моделей по отдельности спросить об одном и том же и получить похожие числа, доверия к ним прибавится.
Посмотрим на кредиты. В обследовании потребительских финансов Банка России был вопрос: думает ли человек сейчас взять кредит или заём? Доля ответивших «да» — 2,5%.
Claude Opus 5.5 предположила 9%. Gemini 4 Argon — 12%. GPT-6 Astra — 15%.
У Alice AI LLM и GigaChat-2-Max получилось по 25%. У YandexGPT Pro 5.1 — 35%. YandexGPT Pro 5.1 завысила долю тех, кто думает о кредите, почти в 14 раз. Модель оценивала ответы за тот же период, когда проводился опрос.
Это один вопрос, и по нему нельзя судить обо всём кредитном рынке. Но он оказался частью более общей картины: все 40 моделей в среднем по учтённым ответам в блоке из семи вопросов о кредитах и долгах завысили долю «да».
То есть модели ошибались в одну сторону. В ресторанном вопросе — больше людей пользовались категорией. В кредитном блоке — чаще отвечали «да». Простое усреднение оценок сохранило бы эти завышения.
Вот это для меня интереснее места в рейтинге. Когда два человека говорят одно и то же, хочется считать это подтверждением. С нейросетями такая привычка может подвести: можно получить несколько похожих ответов и вместе с ними несколько версий одной ошибки.
У ошибки, по крайней мере, появились резервные копии.
Кому тогда доверять?
Самый близкий к опросам общий результат показала Gemini 4 Argon. За ней — Claude Opus 5.5 и Claude Opus 5. При этом по отдельным темам первые места поделили семь моделей:
| Модель | Где её оценки оказались ближе всего к опросам |
|---|---|
| Gemini 4 Argon | Ценности, здоровье |
| Claude Opus 5.5 | Личные финансы |
| Claude Opus 5 | Питание вне дома, технологии |
| GPT-6 Astra | Жильё |
| Claude Fable 5.1 | Такси |
| GPT-6.1 Sol | Покупки |
| Gemini 3.1 Pro Preview | Материальное положение |
Claude Opus 5.5, например, вторая в целом и первая по личным финансам, но четырнадцатая по технологиям и материальному положению. Поэтому я бы выбирал модель под свои вопросы, а не просто брал верхнюю строку общего рейтинга.
И сами места здесь не стоит воспринимать как окончательный вердикт. Покупки представлены всего тремя вопросами, а финансовый блок занимает почти половину набора. Преимущества Gemini 4 Argon над Claude Opus 5 пока недостаточно, чтобы уверенно ждать такого же порядка на другом наборе вопросов.
Пока мы выбираем модель, покупатель тоже меняется.
В обзоре РОМИР, опубликованном в июне 2026 года, описан годовой сдвиг: средние траты на товары повседневного спроса выросли на 11,2%, а за один визит люди стали покупать меньше товаров. Больше потраченных денег ещё не означает больше продуктов в корзине.
Для нашей моцареллы я бы перевёл это в вопросы к предложению. Человек берёт продукт на один ужин или закупается на неделю? Что ему понятнее: выгода за упаковку или стоимость порции? Это уже гипотезы для проверки в своей категории.
Если у вас есть прошлый опрос клиентов, уже можно сделать полезную вещь: показать моделям вопросы, скрыть результаты и сравнить оценки с ответами людей. Особенно внимательно я бы посмотрел на тех, кто не покупает, не пользуется и затрудняется ответить. В наших примерах именно таких людей моделям заметно не хватало.
Есть граница и у нашей проверки: исследования уже были опубликованы, какие-то ответы могли попасть в обучение моделей. Точность прогноза продаж нового продукта или качество интервью с виртуальными респондентами этот тест не устанавливает.
Проверять идею для российского рынка одним разговором с нейросетью я бы не стал. Слишком много зависит от того, какого покупателя она себе представила.
Для таких задач мы и делаем «Лабораторию №40». У нас можно проверить идею на синтетической аудитории российского рынка: её состав калибруем по демографической статистике, а в основе персон — данные реальных опросов. Подбираем аудиторию под вашу задачу и смотрим, как на предложение реагируют разные группы.
Приходите с описанием новинки, двумя названиями, вариантами сообщения на упаковке или условиями акции. Сравним, как их понимают разные группы, разберём возможные возражения и поможем выбрать, что доработать и проверить с покупателями перед запуском. Проверить свою идею →
Хотите увидеть полные результаты исследований на все 40 моделей в одной таблице? Свяжитесь с нами!
Николай Сорокин, основатель «Лаборатории №40» · lab-40.ru