
В нашем отчёте о проверке точности есть цифра 92%. Мы получили её честно, по заранее зафиксированному протоколу, и всё же считаем, что сама по себе она ничего не доказывает. В этой статье расскажу, как мы пришли к такому выводу, проверяя собственную синтетическую панель, и предложу три вопроса, которые помогают разобраться с любой заявленной точностью синтетических респондентов, включая нашу.
Сначала контекст. Синтетические респонденты — это виртуальные участники опросов на основе языковых моделей. Им задают те же вопросы, что и живым людям, а модель отвечает от лица конкретного человека с заданным полом, возрастом, доходом и биографией. Я развиваю такую панель: в ней 100 тысяч персон, собранных из многолетнего всероссийского обследования домохозяйств и выровненных по данным переписи 2020 года.
Рынок этой технологии растёт, и каждый поставщик называет свою цифру точности. В июле 2025 года «Родная Речь» опубликовала для своего продукта Synth долю совпадений инсайтов с реальными людьми: 65% у миллениалов, 55% у зумеров и 45% у поколения альфа. Методика при этом не публиковалась и за прошедший год так и не появилась (мы перепроверили перед выходом статьи). Для рынка, включая западный, это обычная ситуация: СберМаркетинг, например, осенью 2025-го сравнил своего синтетического респондента «скуфа» с реальным исследованием досуга и подвёл итог словами «во многом совпали», уже вовсе без цифр.
Я не считаю это претензией к конкретным компаниям: общепринятого стандарта проверки синтетики пока просто нет. Поэтому мы взяли постановку Synth как ориентир и устроили собственной панели проверку заметно жёстче отраслевой, заранее пообещав опубликовать все результаты, в том числе неудобные для нас.
Почему «доля совпавших инсайтов» сама по себе мало что значит
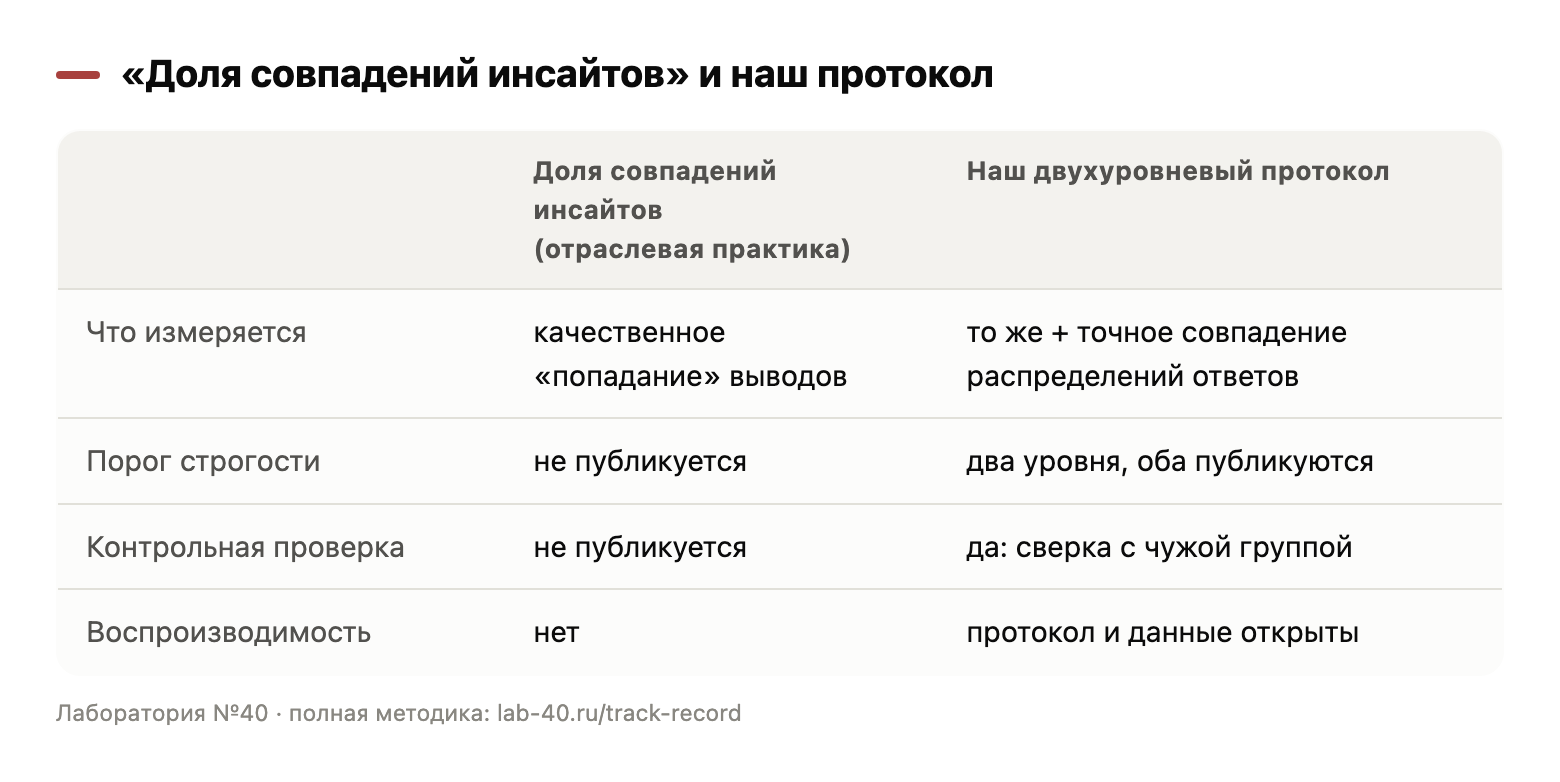
По публичным описаниям можно восстановить, как такие цифры считаются. Из ответов синтетики извлекают инсайты, то есть обобщающие выводы о группе, и сравнивают их с инсайтами полевого исследования; доля совпавших и есть точность. Сама по себе схема разумная, но в ней остаются две незакрытые степени свободы.
Порог строгости. Что считать совпадением: тот же самый вывод или просто ту же тему? Между «зумеры экономят на еде ради впечатлений» и «зумеры по-другому относятся к деньгам» большая разница, но при мягком пороге оба утверждения засчитываются как совпавшие.
Контроль осмысленности. Совпадут ли те же инсайты с ответами заведомо другой группы? Если совпадут, значит, метрика засчитала утверждения, верные для любого взрослого человека, и об особенностях поколения они ничего не говорят.
Если не зафиксировать оба параметра, можно честно получить любую долю совпадений от 45 до 92 процентов. Мы зафиксировали оба, и дальше расскажу, что после этого произошло с нашими цифрами.
Как проверяли: два уровня и контрольная группа
Весь протокол зафиксирован в git до запуска, это можно проверить по хэшам коммитов.
Уровень 1: та же метрика, что у индустрии, плюс контроль. Из четырёх открытых поколенческих исследований ВЦИОМ мы заранее выписали по 12 инсайтов о зумерах, миллениалах и поколении X. Пример такого инсайта: «треть зумеров считает, что за традиционные семейные ценности держаться не стоит». Затем синтетические группы тех же поколений прошли открытые интервью, и из их ответов инсайты извлекались тем же способом. Совпадения оценивала языковая модель другого семейства, чем та, на которой работает панель, вслепую и в два прохода. Главное отличие от отраслевой практики: каждый набор реальных инсайтов мы дополнительно сверили с ответами чужого поколения. Это контрольная группа для метрики точности.
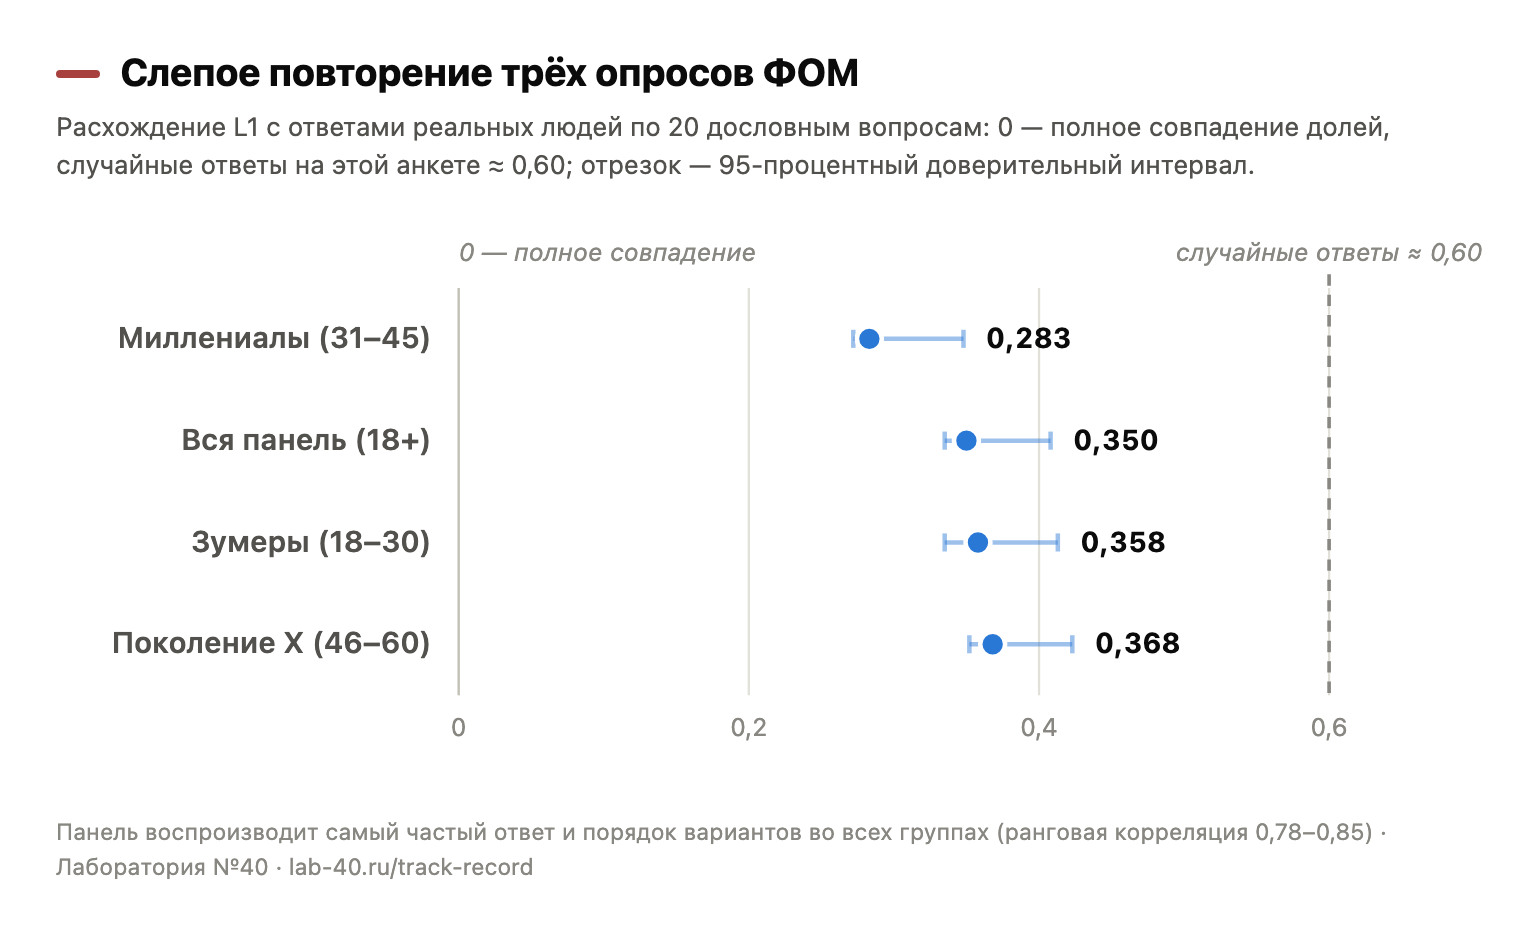
Уровень 2: слепое повторение распределений. Таких публичных проверок синтетики мы на рынке пока не встречали. Панель отвечала на 20 дословных вопросов из трёх всероссийских опросов ФОМ; в коде генерации физически нет доступа к реальным результатам, а сравнение распределений делает отдельный скрипт уже после прогона. Одна из волн ФОМ при этом прошла поле в мае 2026 года, позже среза знаний любой языковой модели, так что у проверки есть встроенная защита от «подглядывания»: ответов на майскую анкету в обучающих данных быть не может.
Результаты: сначала приятные
Совпадение инсайтов по теме получилось высоким у всех трёх поколений, от 75 до 92%. Формально мы «обошли» отраслевые 65/55, и если бы остановились на этом месте, как обычно все и останавливаются, вышел бы неплохой пресс-релиз.
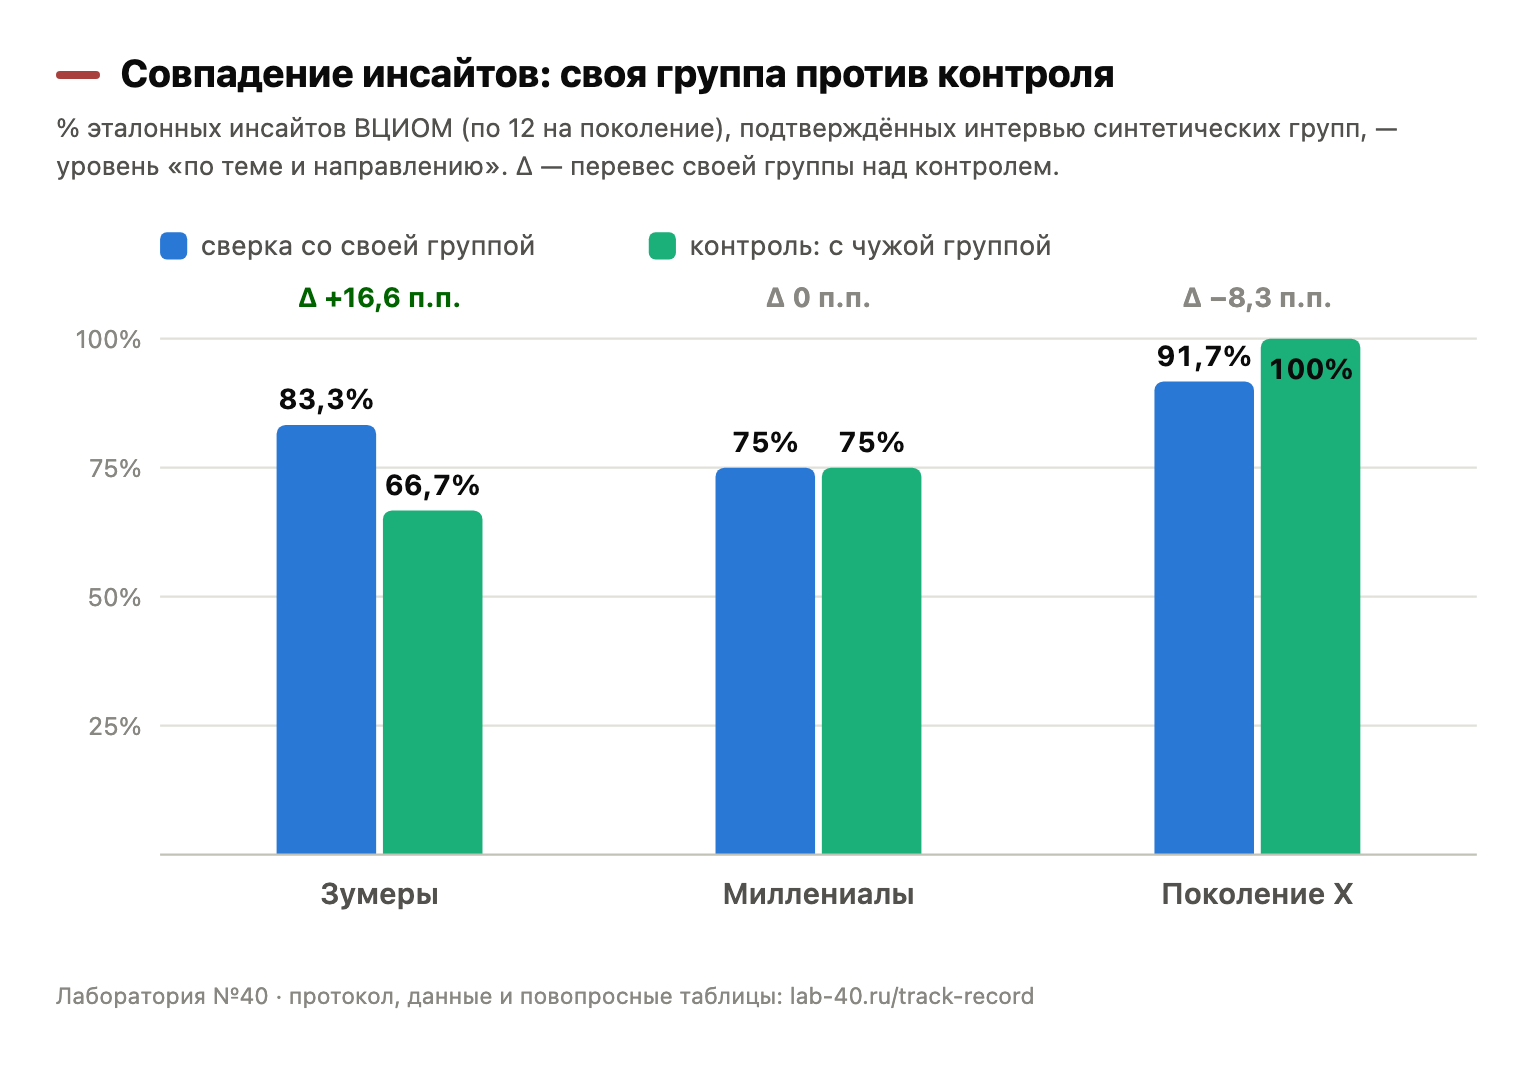
Дальше сработал контроль. У зумеров чужая группа подтверждает их инсайты в 67% случаев против 83% у своей: перевес в 17 п.п. говорит, что поколенческая специфика здесь настоящая. У миллениалов контроль сравнялся с целевой группой, 75 на 75. А у поколения X чужой корпус совпал с «иксовыми» инсайтами даже лучше собственного: 100% против 92%.
На живых примерах разница хорошо видна. Упомянутый инсайт про треть зумеров и традиционные семейные ценности синтетические зумеры воспроизводят именно как вывод, тогда как у синтетических миллениалов и иксов на эту тему встречаются только общие рассуждения о семье. Для сравнения возьмём инсайт «для поколения X крепкая семья — доминирующая ценность»: его «подтверждает» вообще любой корпус, включая зумерский, потому что о ценности семьи так или иначе говорят все взрослые. В «долю совпадений» оба примера входят с одинаковым весом, хотя о поколении что-то говорит только первый.
Получается, что две трети нашего красивого результата описывали общие свойства взрослых россиян, и лишь результат зумеров действительно относился к поколению. Цифрой «точность 92% на поколении X» вполне можно было бы открывать продажи: она честно посчитана. Просто поколенческой специфики за ней нет, и без контрольной сверки мы бы об этом даже не узнали. Подозреваю, что и те, кто публикует похожие цифры без контроля, знают о своих метриках не больше.
На слепом уровне, где подогнать результат уже не получится, панель воспроизвела самый частый ответ и порядок вариантов во всех поколениях: ранговая корреляция составила от 0,78 до 0,85. Случайное заполнение той же анкеты дало бы ошибку около 0,60, и все группы держатся от этой границы далеко.
Слабые места мы публикуем в том же реестре. По потребительским частотам, вроде «как часто вы покупаете…», панель отвечает заметно хуже, чем по ценностным темам. Худшая ячейка выглядит так: панель завышает, как часто поколение X ест вне дома, хотя в реальности 57% людей 46–60 лет не делают этого никогда. Отдельно отмечу, что майская волна далась панели хуже старых; если бы модель подглядела ответы в обучающих данных, картина была бы обратной, так что этот минус заодно подтверждает чистоту слепой проверки.
Проверка, которую не подделаешь задним числом
У самовалидации, даже с контролем, есть предел доверия: протокол наш и данные наши. Поэтому параллельно мы ведём реестр запечатанных прогнозов. Перед выходом очередного всероссийского опроса панель отвечает на его анкету, прогноз публично фиксируется криптографическим отпечатком SHA-256 ещё до публикации официальных результатов, а после их выхода вскрывается и сверяется. Слепок реестра с отпечатком дополнительно сохраняется в независимом интернет-архиве, поэтому подрисовать дату задним числом не получится.
Первые два запечатанных прогноза индекса потребительских настроений уже вскрыты. Июльский прогноз старой версии движка разошёлся с официальными данными на 0,273 в той же метрике расхождения, что и на графике выше (ноль означал бы точное совпадение долей). Прогноз обновлённой версии, запечатанный до выхода тех же данных, разошёлся на 0,203, то есть ошибка на неподсмотренном будущем уменьшилась на 26%. Лежат в реестре и наши промахи: например, июльский прогноз «шокового» ценового вопроса разошёлся с официальной цифрой на 2,25 п.п. Такие записи остаются в реестре навсегда, в этом и смысл инструмента.
Три вопроса, которые стоит задать любому поставщику синтетики
Чек-лист короткий и относится к нам в той же мере, что и к остальным.
- Протокол зафиксирован до запуска? Методика, сформулированная после получения результата, позволяет подогнать что угодно.
- Есть контрольная проверка? Спросите, что показала сверка с заведомо другой группой. Если её не проводили, доля совпадений может складываться из утверждений, верных для кого угодно.
- Результат воспроизводим? Хорошо, когда открыты данные, промпты и повопросные таблицы, а не только итоговый слайд.
Наши материалы по всем трём пунктам открыты на lab-40.ru/track-record: методика, реестры, таблицы по каждому вопросу и запечатанные прогнозы с хэшами. И если у вас есть прошлогодний опрос, пришлите анкету: повторим его вслепую, сравним и опубликуем расхождения вместе с совпадениями.
Николай Сорокин, «Лаборатория №40» — синтетическая панель потребителей: тест концепта, цены или названия до запуска, отчёт в тот же день.