
Можно сравнить синтетические ответы с уже известным опросом и обнаружить хорошие совпадения. Более требовательная проверка — сначала сохранить прогноз, а затем дождаться результатов реального исследования.
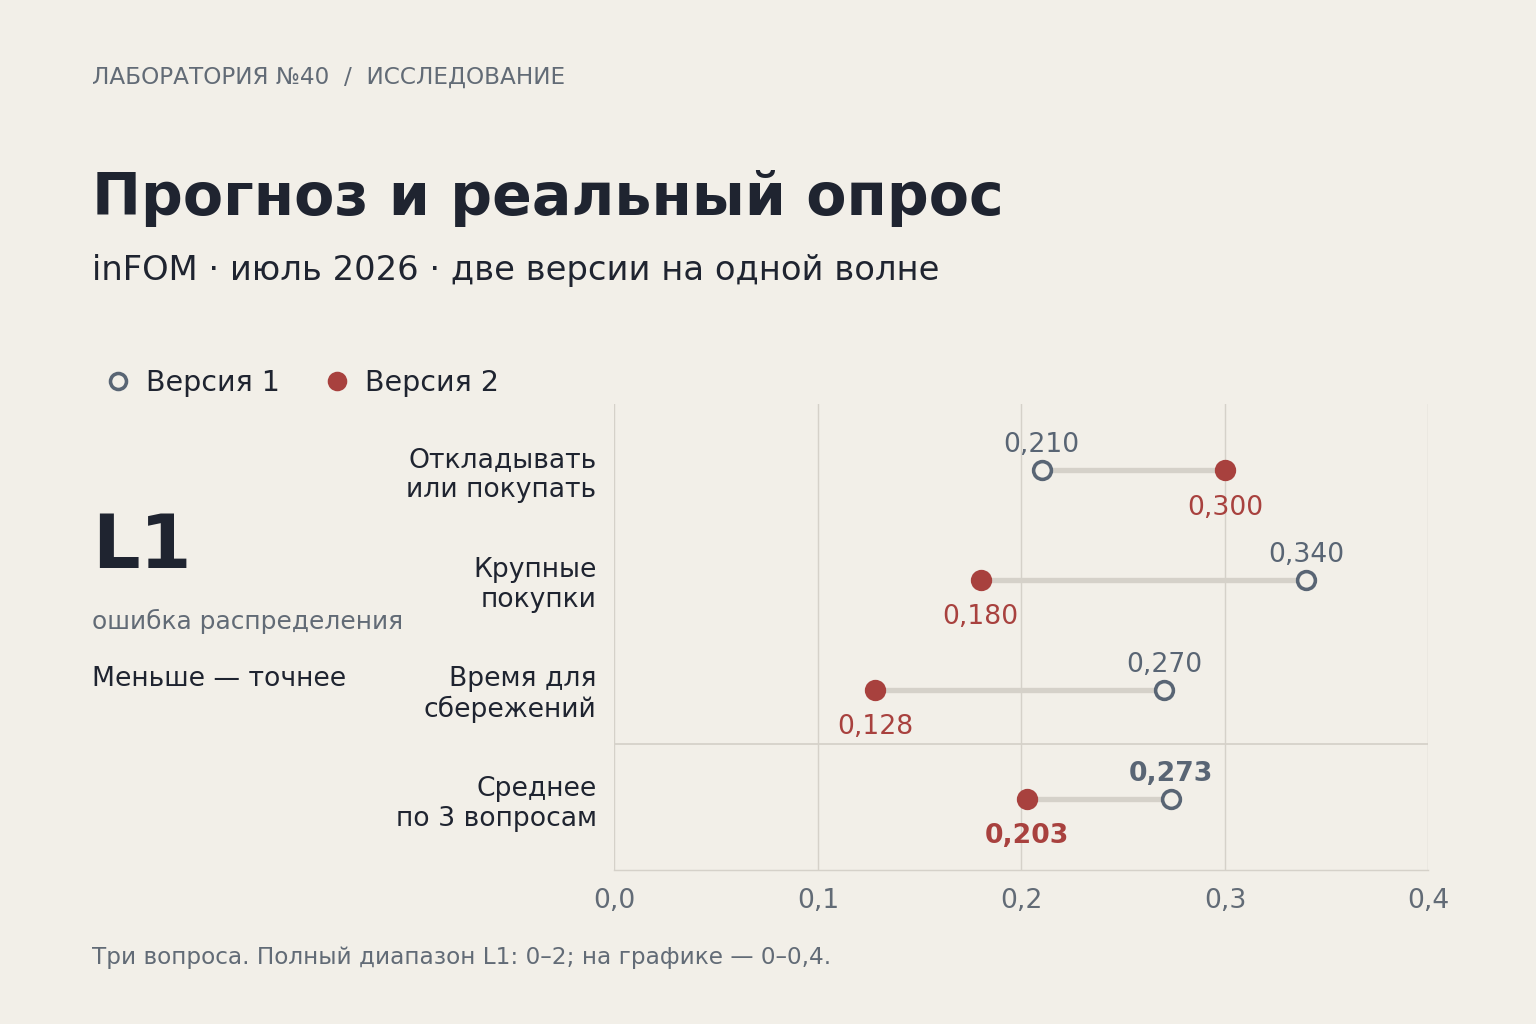
Мы провели такую сверку для июльской волны инФОМ: зафиксировали две версии прогноза и сравнили их с опубликованными распределениями ответов. Средняя ошибка обновлённой версии оказалась ниже примерно на четверть. При этом по одному из трёх вопросов она выросла. Ниже — что именно сравнивалось и где остались расхождения.
Три вопроса о покупках и сбережениях
Мы выбрали три вопроса из исследования инФОМ для Банка России:
- Лучше сейчас откладывать свободные деньги или покупать дорогостоящие товары?
- Хорошее или плохое сейчас время для крупных покупок для дома?
- Хорошее или плохое сейчас время, чтобы делать сбережения?
Для каждого вопроса прогнозировали доли всех вариантов ответа, включая затруднившихся. Затем сверяли их с общероссийскими и социально-демографическими таблицами июльского отчёта инФОМ. В расчётах использованы округлённые проценты из приложения; внутри каждого распределения доли приведены к сумме 100%.
Предмет проверки — ответы на три конкретных вопроса. Общий индекс потребительских настроений, фактическую инфляцию и объём продаж эта сверка не прогнозирует.
Как мы сохранили прогноз заранее
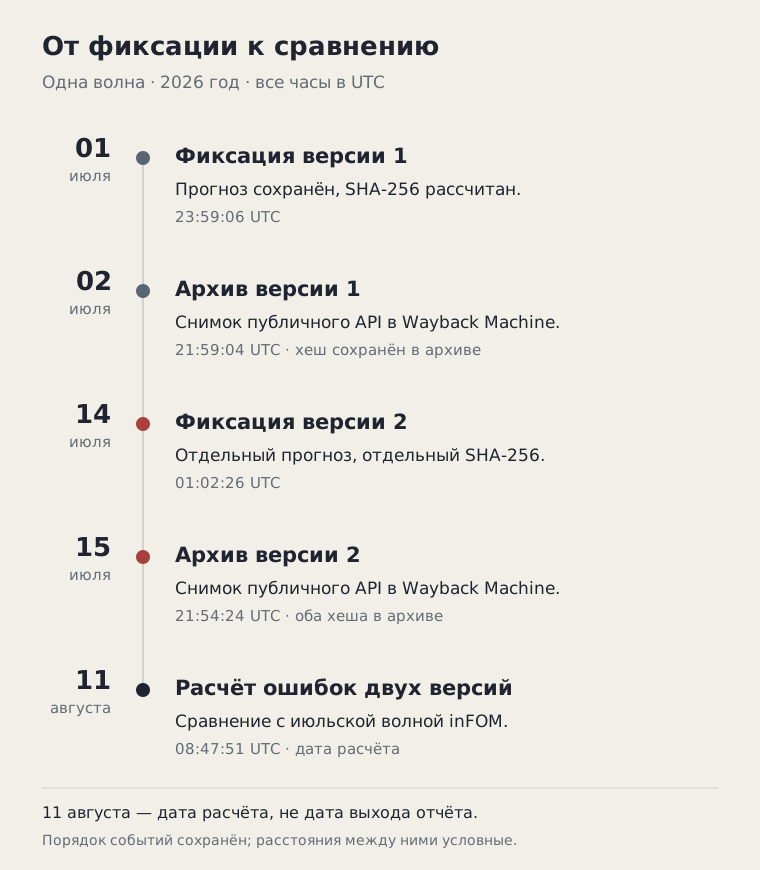
Первый прогноз зафиксирован 1 июля 2026 года по UTC. Для файла рассчитана контрольная сумма: цифровой отпечаток, который изменится при изменении содержимого. Её опубликовали в журнале, а архивная копия от 2 июля сохранила внешнюю отметку времени.
Обновлённая версия получила отдельный файл и отдельную контрольную сумму 14 июля по UTC. Для неё есть архивная копия от 15 июля. Исходный прогноз остался в журнале: новая версия дополнила его.
Полевой опрос инФОМ проходил с 6 по 15 июля среди 2 007 человек. Первая версия зафиксирована до начала сбора ответов, вторая — во время него. Обе относятся к проверке до публикации результатов.
 Открыть график в полном размере
После появления результатов обе версии оценили одним способом. Теперь открыты полные файлы первого прогноза и обновлённого. Их можно скачать, пересчитать контрольные суммы и сопоставить с сохранёнными отметками. Порядок проверки описан в публичном журнале.
Что различалось между версиями
Первая версия собирала ответы панели из 200 синтетических профилей. Итоговое распределение складывалось из их ответов на вопросы.
Вторая оценивала распределения напрямую: движок выдавал предполагаемые доли вариантов по стране и отдельным группам. Поэтому приписывать ей «200 опрошенных респондентов» было бы неверно.
Одновременно изменились формулировки: первая версия использовала вопросы на английском, вторая — на русском. Менялись способ получения оценок и инструкции модели. Разница в результате относится ко всему обновлению. По этой сверке нельзя выделить вклад одного изменения — например, утверждать, что улучшение вызвано только прямой оценкой распределений.
Как читать величину ошибки
Для сравнения мы использовали L1: складывали абсолютные расхождения между прогнозом и опросом по каждому варианту ответа. Доли берутся от 0 до 1. Нулевая ошибка означает совпадение распределений; максимально возможное значение — 2. Чем меньше число, тем ближе прогноз к опубликованным ответам.
Посмотрим на первый вопрос: что лучше делать со свободными деньгами.
| Ответ | Первая версия | Обновлённая версия | Опрос инФОМ |
|---|---|---|---|
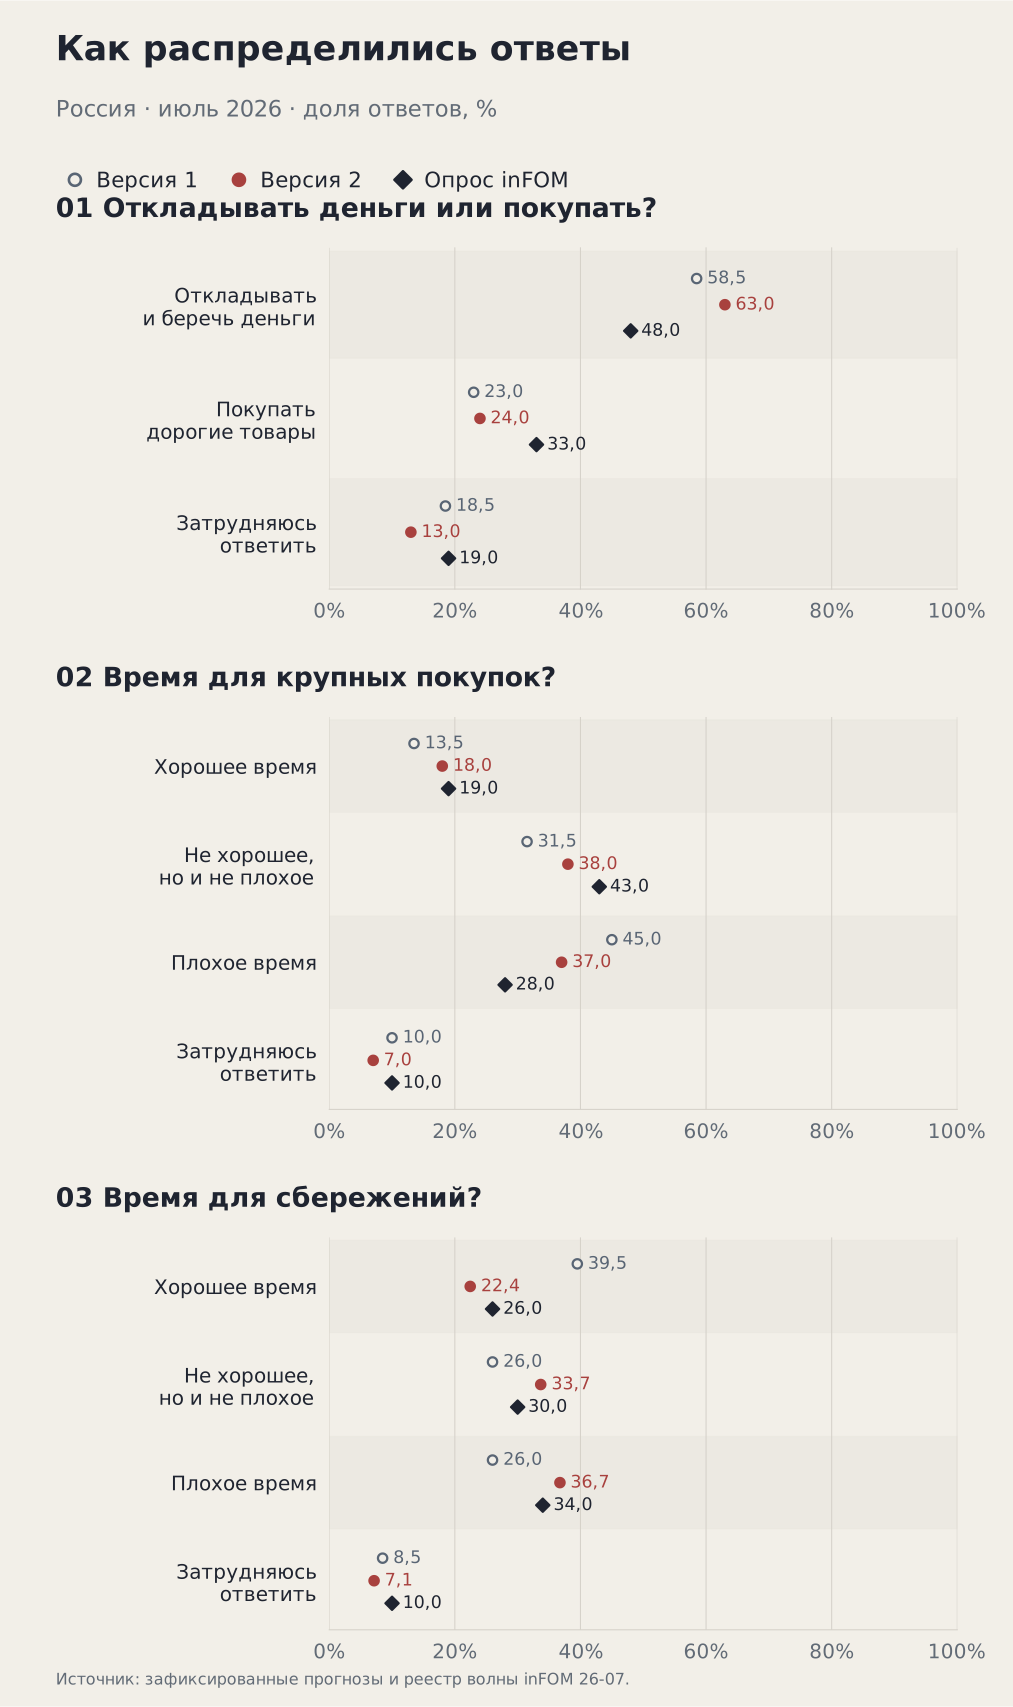
| Откладывать и беречь | 58,5% | 63% | 48% |
| Покупать дорогостоящие товары | 23% | 24% | 33% |
| Затрудняюсь ответить | 18,5% | 13% | 19% |
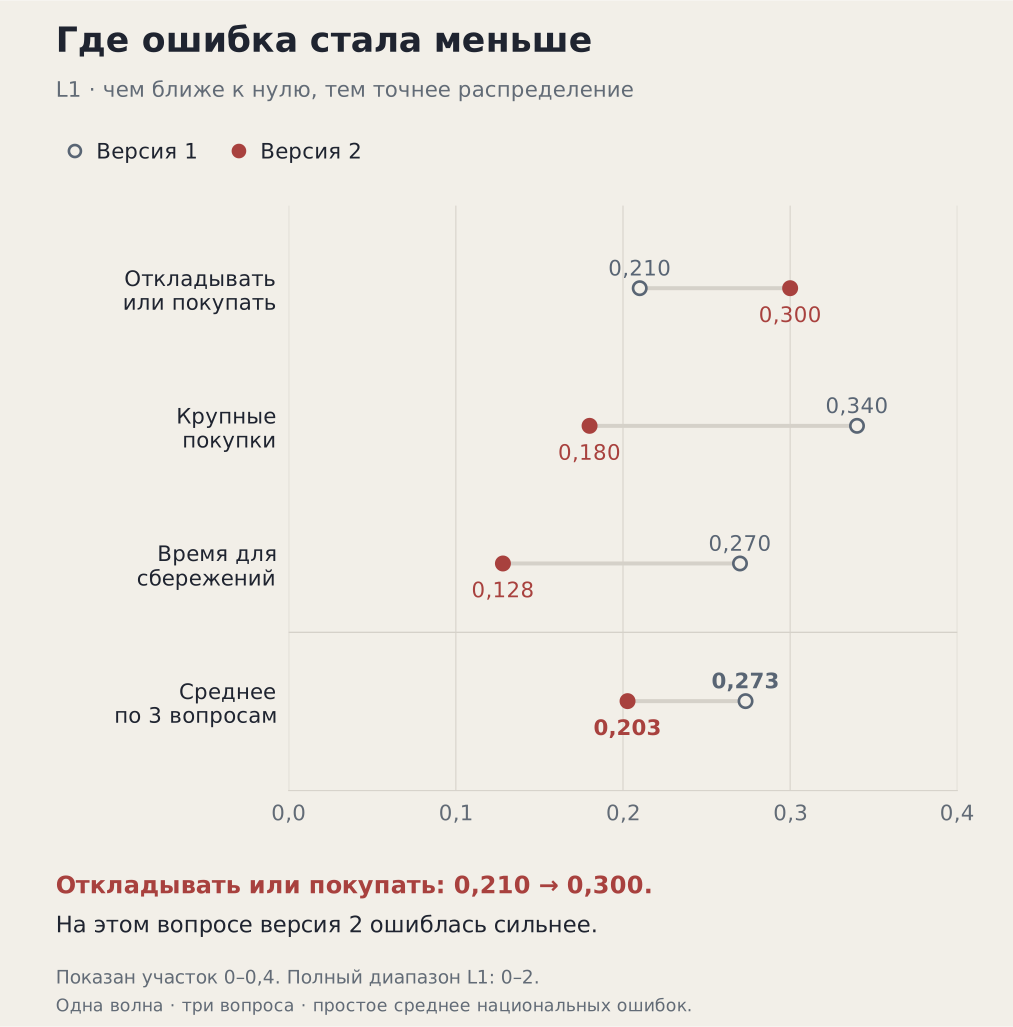
У первой версии расхождения составили 10,5, 10 и 0,5 процентного пункта. В долях это 0,105 + 0,10 + 0,005 = 0,21 L1. У обновлённой версии: 0,15 + 0,09 + 0,06 = 0,30 L1. На этом вопросе ошибка выросла.
L1 не является процентом точности. Из ошибки 0,21 нельзя заключить, что прогноз «точен на 79%».
Где прогноз приблизился к опросу
По вопросу о крупных покупках для дома ошибка снизилась с 0,34 до 0,18. Первая версия ожидала, что плохим время назовут 45%, обновлённая — 37%. В опросе этот вариант выбрали 28%. Расхождение уменьшилось, хотя обе версии переоценили долю отрицательных ответов.
По вопросу о времени для сбережений ошибка снизилась с 0,27 до 0,128163. Первая версия ожидала 39,5% ответов «хорошее время» при 26% в опросе. Обновлённая оценка составила примерно 22,45%: она оказалась с другой стороны от фактической доли, но заметно ближе.
 Открыть график в полном размере
Среднее L1 по трём общероссийским распределениям снизилось с 0,273333 до 0,202721. Относительное снижение составило 25,83%: разницу ошибок разделили на ошибку первой версии. Это улучшение среднего показателя на данной волне; оно включает два улучшившихся вопроса и один ухудшившийся.
 Открыть график в полном размере
Точные доли и ошибки можно скачать в таблице CSV. Отдельный файл с источниками и контрольными суммами позволяет проверить, на каких данных построены графики.
Что скрывается за общим результатом
Национальное среднее может выглядеть приемлемо, пока в отдельной группе сохраняется большое расхождение. В группе «старше 60 лет» по вопросу «откладывать или покупать» L1 снизилось примерно с 0,628 до 0,562, но осталось существенно выше общероссийского.
Первая версия ожидала, что сбережения выберут 72% этой группы, обновлённая — около 68,7%. В таблице опроса, страница 82, указан 41%. Три округлённые доли этой группы — 41%, 29% и 31% — в сумме дают 101%. Для расчёта они нормированы: 41 / 101 ≈ 40,6%. Обе версии заметно переоценили сберегательную установку. Этот промах сохранён в журнале вместе с удачными результатами.
Для практической задачи такое расхождение существенно. Если предложение рассчитано на старшую аудиторию, общий показатель по стране не отвечает на вопрос о пригодности прогноза для неё. Нужна проверка нужной группы и той темы, на которой строится решение.
Что можно перенести в работу
Пока это одна волна внешнего опроса и две версии прогноза. Чтобы судить об устойчивости результата, нужны следующие волны, заранее сохранённые прогнозы и сравнение с простыми альтернативами — например, с переносом предыдущего опубликованного распределения. Разница между этими двумя версиями сама по себе не доказывает устойчивого преимущества метода.
Полезный принцип для команды уже понятен: до теста записать ожидаемый результат, выбрать показатель и сохранить предположения. После теста разобрать улучшения, ухудшения и различия между сегментами. Так исследование помогает определить, на что можно опираться в следующем решении.
Для коммерческого продукта следующим шагом остаётся сверка на своей задаче: реакции на оффер, подключении, покупке или повторном использовании. О более широкой проверке синтетической аудитории и её ограничениях рассказываем в статье «Где синтетическая аудитория совпала с реальными опросами — и где ошиблась».